No es raro encontrarse con numerosos commits en el historial de Git, dedicados a corregir pipelines. Esto ocurre porque probar pipelines puede ser complicado y, en última instancia, la única manera de verificar si realmente funcionan es hacer push del código y observar su comportamiento.
A lo largo de los años, he probado varias estrategias para simplificar las pruebas de pipelines, y estas son las “mejores prácticas” que me funcionan.
Encapsular la funcionalidad en scripts
Un enfoque práctico es encapsular la mayoría de los pasos en scripts (bash, PowerShell, Python, Make, etc.). Esto facilita probar la pipeline localmente sin depender de frameworks ni herramientas complejas. No solo te permite probar la mayor parte de la funcionalidad en local antes de hacer push del código, sino que además acelera la depuración gracias al feedback inmediato.
Utilizar un linter
Utilizar un linter es muy recomendable siempre que estamos desarrollando código, y eso incluye las pipelines. Utiliza un Entorno de Desarrollo Integrado (IDE), como Visual Studio Code, que incorpore un linter para el lenguaje y esquema de pipeline que estés usando. Esto ayuda a detectar errores de sintaxis y fallos comunes antes de hacer push del código.
Evitar herramientas para pruebas locales
Aunque puede resultar tentador usar herramientas que emulen localmente el entorno de la pipeline, creo que este es un enfoque arriesgado. El entorno de la pipeline es complejo, lo que hace difícil replicarlo con precisión en local. Esto puede generar una falsa sensación de seguridad y llevar a subir código que no funciona. Además, en pipelines complejas, depender de una emulación local puede terminar añadiendo código innecesario, con la consiguiente sobrecarga de mantenimiento y posibles fuentes de bugs.
Trabajar en una rama dedicada
Cuando no estés seguro del funcionamiento de la pipeline (que debería ser siempre), crea una rama nueva para hacer pruebas. Esto te permite hacer push del código y evaluar su comportamiento sin afectar a la rama principal. Una vez que tengas confianza en que funciona, fusiona la rama en la principal usando un squash merge para mantener un historial limpio.
Un ejemplo real
Recientemente desarrollé una GitHub Action diseñada para minificar archivos HTML usando HTMLMinifier. En GitHub, un workflow (pipeline) debe estar definido en la rama por defecto antes de poder utilizarse. En consecuencia, empecé haciendo push del esqueleto de la pipeline, con un contenido similar a hello world, a la rama principal. Después, creé la rama dev y comencé a trabajar en la pipeline desde Visual Studio Code.
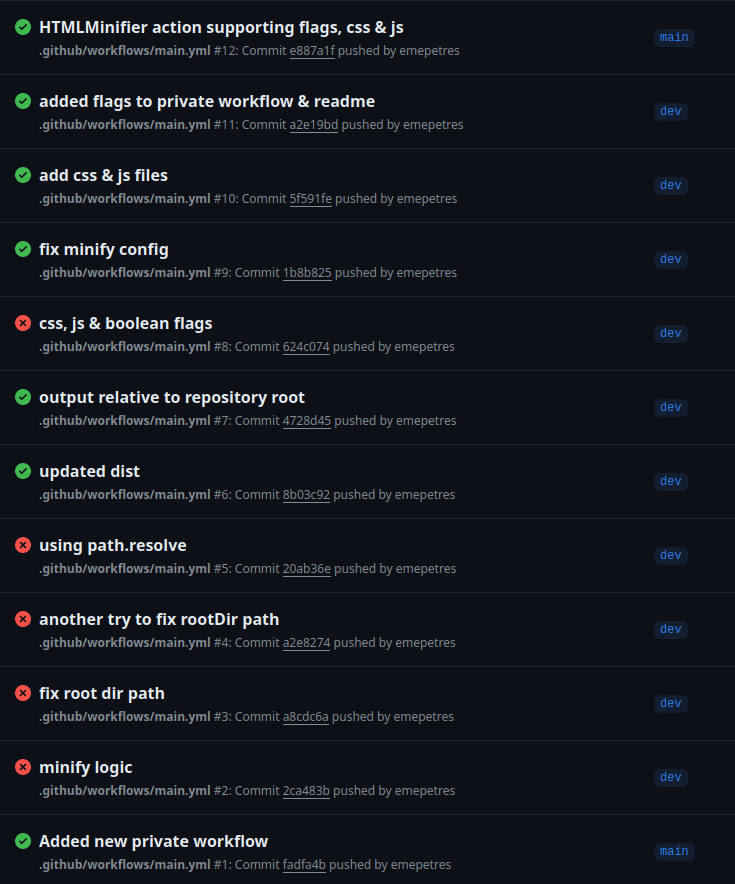
Probé la pipeline localmente usando scripts de JavaScript que escribí. Una vez que verifiqué que funcionaba, hice push del código a la rama dev. Después de probarla a fondo, donde encontré algunos problemas con el directorio de trabajo, hice un squash merge, integrando la rama dev en la rama principal y manteniendo un historial limpio.